FPGA AI助手实战指导教程——写给一线工程师的上手手册
摘要 :2026 年9–10 月,AMD Ross、Altera QuartusIQ、Lattice Prompt 三大FPGA 厂商AI 助手在两个月内集中落地。本文从一线FPGA 工程师视角,讲清楚这些助手到底是什么、怎么选、怎么搭建环境,以及时序收敛、HLS 移植、查文档写约束调试三大高价值场景的正确用法和红线守则,附四周上手路线图。
适用对象 :日常使用Vivado / Quartus / Radiant 做RTL 设计、时序收敛、上板调试的FPGA 工程师。
资料截至2026-11-02,产品状态以厂商最新发布为准。一句话定位:这些AI 助手不替你做设计决策,但替你跑流程、查文档、调时序、试方案——你的价值向"判断与决策"集中。
先搞清楚:AI 助手到底是什么
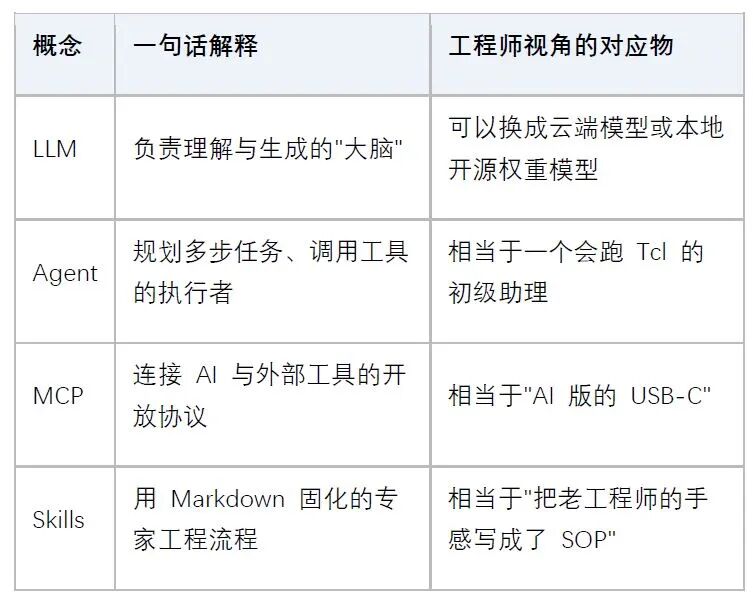
动手之前,先用一张架构图把概念理清。目前三家国际大厂( AMD 、 Altera 、 Lattice )的助手架构高度一致:
AI 客户端 + LLM ( Claude / GPT / DeepSeek / Kimi / Nemotron … ,你自己选)
Agent 编排层(规划多步任务、拆解你的意图)
MCP Server (开放协议,把 AI 接到 EDA 工具上)
EDA 工具链( Vivado / Quartus Prime Pro / Radiant )
厂商知识库( RAG 检索官方文档) + Agent Skills (专家经验封装的工作流)
重要认知 :这些助手不是 "AI 自己设计芯片 " 。它们读报告、给建议、自动改约束和 RTL ,但所有改动在执行前都需要你批准(强制人工审批门控)。你是决策者, AI 是执行者。
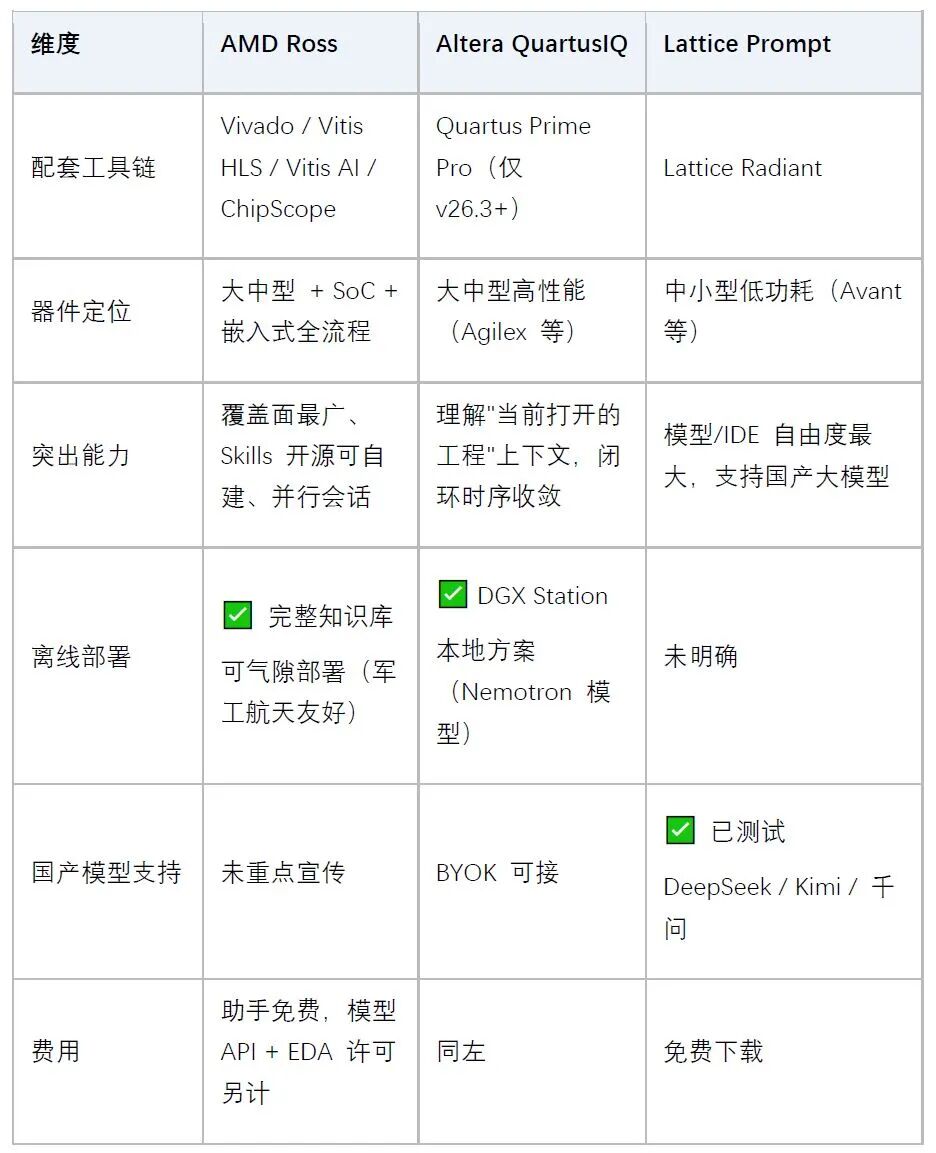
涉密项目、需要自建企业知识沉淀 → AMD Ross
用大器件、希望 AI 懂你当前工程的约束与时序报告 → QuartusIQ (注意需升级到 Pro 26.3 )
中小型器件、预算有限、想用 DeepSeek/Kimi → Lattice Prompt
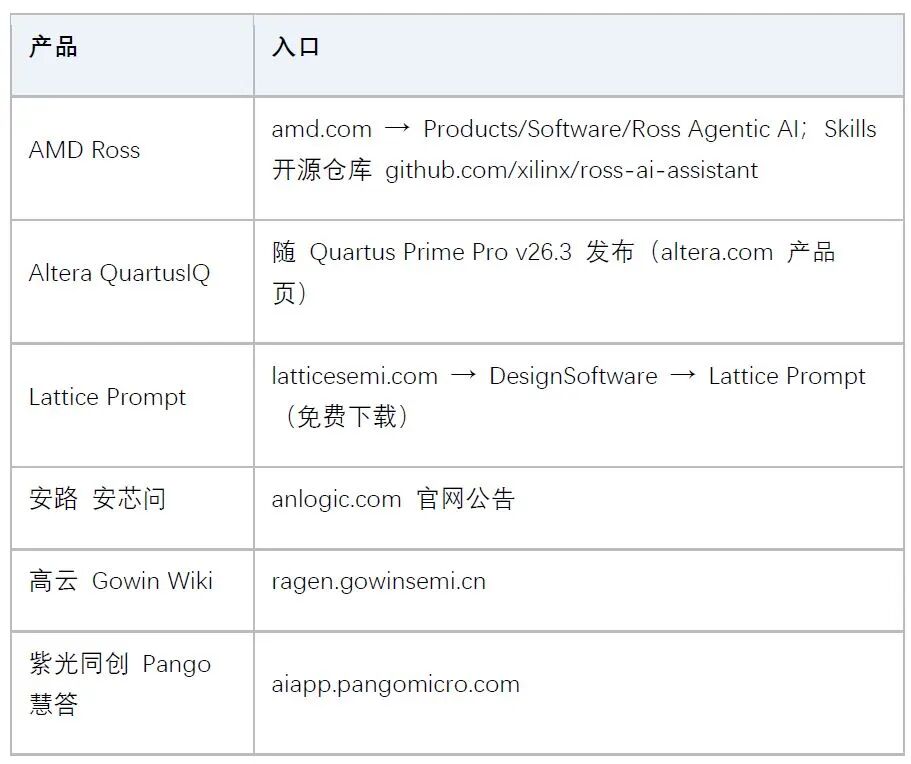
用国产 FPGA (安路 / 高云 / 紫光同创)→ 目前只有知识问答(安芯问 /Gowin Wiki/Pango 慧答),完整 Agent 工作流可关注第三方 IC Coder
上手第一步:环境搭建(以通用三步法为例)
三家安装方式大同小异,以 Lattice Prompt 为最简示例:
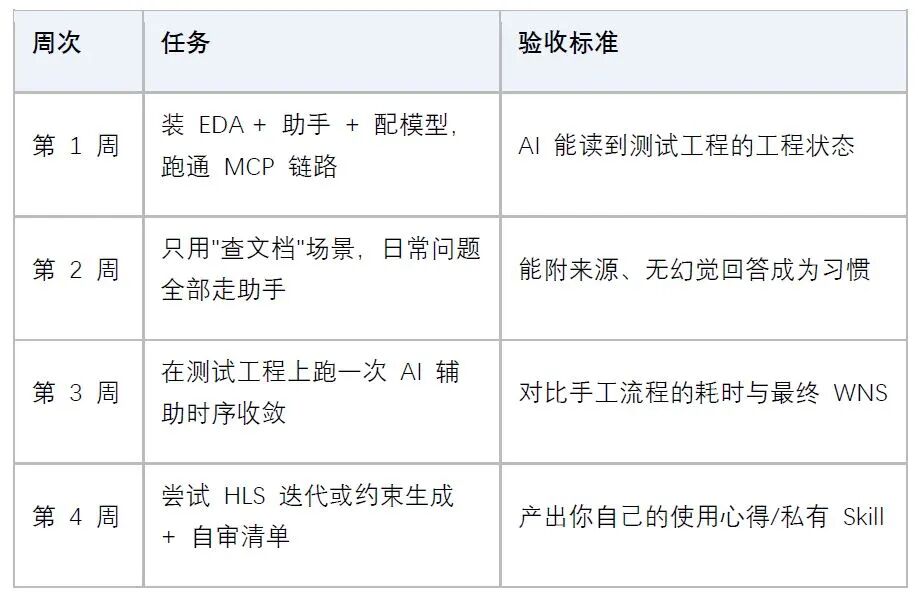
第 1 步:装 EDA 工具 + AI 助手本体
确认 EDA 工具版本符合要求(如 Lattice Prompt 需最新版 Radiant ; QuartusIQ 需 Prime Pro 26.3 ),从厂商官网下载助手(均为免费下载)。
第 2 步:准备 LLM 接入
云端路线:在 Cursor / VS Code / Claude Code 里配好你选择的模型API Key。
本地路线(涉密团队):准备推理环境——AMD 需数据库+ Embedding 模型 + MCP Server ; Altera 方案优化于 NVIDIA DGX Station + Nemotron 开放权重。
第 3 步:连接 MCP ,验证链路
在 AI 客户端中注册厂商提供的 MCP Server 配置。
验证方法:让 AI" 查询当前工程的器件型号 " 或 " 列出 Vivado 工程状态 " 。 它能读到真实工程信息,说明链路通了。
⚠️ 避坑: 先在 非涉密的测试工程 上跑通全流程,再引入正式项目。第一次让 AI 动你的量产工程约束文件是大忌。
这是所有助手宣传里数据最硬的场景,也是最值得你优先导入的场景。
传统:看 report_timing_summary → 人肉分类几百条违例路径
→ 试约束 → 重编译 → 看 WNS → 循环到凌晨 ……
你: " 当前工程 WNS = -0.5ns ,帮我分类违例路径并给出收敛方案 "
AI :自动分类失败路径 → 识别布线拥塞 / 逻辑级数 / 扇出问题
→ 建议约束调整或 RTL 流水线改动 → (你批准) → 自动迭代重跑
Lattice:量子纠错解码器 5ns 违例、目标200MHz,4 小时定位根因并收敛(常规需数天)
AMD Ross:可自主迭代修复直到违例归零;支持并行会话(一个会话跑布线,另一个会话继续干活)
先让 AI 读报告、分类、给方案,不要一上来就让它改文件。
审查它建议的每一处约束修改: false_path 、 multicycle_path 乱加就是过约束,签核时雷会被埋下。
涉及 RTL 结构改动(插流水线、复制寄存器)的, 改完必须回到仿真回归 —— AI 不会主动替你补仿真。
用厂商 Skills 固化的时序方法学流程(如 AMD 的时序方法学 Skill ),比自己凭记忆查 UG949 靠谱。
高价值使用场景二:HLS / 算法移植
AMD Skills 中超过一半与 HLS 相关,这是目前 AI 助手 " 含金量 " 最高的领域。
典型案例:CUDA 的 OCT 重建算法移植到Lattice Avant,30 小时完成(常规数月);图像去马赛克流水线借助 Vitis 优化技能 2 小时达吞吐目标,LUT 减少35%。
怎么用:把源码和性能目标(吞吐/延迟/资源预算)描述给 AI → 调用HLS 优化 Skill(如/hls-optimize)迭代 pragma、数据流、行缓存方案 → 每轮迭代看综合日志与仿真结果。LLM+RAG 闭环框架正是靠"把综合日志喂回模型"实现手工调优减少70%。
注意: MATLAB → C++ 转换类任务有现成 Skill ,但 数值精度(定点化)必须自己核对 , AI 对舍入误差的判断不可靠。
高价值使用场景三:日常"查文档 + 写约束 + 调试"
这是见效最快的用法,建议所有工程师 今天就导入 :问法要精确,例如 "Vivado 里 set_clock_groups -asynchronous 和 set_false_path 在这个跨时钟域场景该用哪个?参考时钟 100MHz ,目的时钟 156.25MHz" 。助手回答 grounding 在官方文档库(附来源),比通用大模型瞎编 API 可靠得多。
给出管脚表、电平标准、 Bank 划分,让 AI 生成 XDC/SDC 草稿;
必做自审:让它输出 " 过约束 / 漏约束自查清单 " ,这一步不能省。
上板异常时,把现象、 ILA 抓到的波形描述给 AI ,让它按 " 信号没动 / 动了但不对 / 对了但输出端错 " 帮你二分定位;
AMD Ross 路线图中 ChipScope 调试工作流已纳入,可自动插 debug 核并重跑 flow 。
红线与守则:AI 时代 FPGA 工程师的自我修养
❌ 不审直接放行:AI 的约束修改、RTL 改动必须逐条review 后再批准执行。
❌ 跳过仿真:任何 RTL 改动后必须回归对应层级仿真——签核责任在你,不在AI。
❌ 涉密数据上云:军工/车规/未流片 IP,用离线部署方案(AMD 气隙、Altera DGX 本地),或干脆不用云端助手。
❌ 拿厂商宣传数据当验收指标:"10 倍效率"是营销口径,未经独立审计,以你自己工程的实测为准。
✅把AI 当"会跑 Tcl 的初级助理":它执行,你决策。
✅善用Skills:优先调用厂商验证过的工程流程,而不是裸问大模型。
✅团队沉淀:参考AMD 开源Skills 模式,把本团队的时序收敛套路、调试checklist 写成私有Skill/文档,统一团队工程方法。
✅保留追问证据的习惯:让AI 给出修改依据(文档引用、报告数据),拒绝"应该没问题"。
MCP ( Model Context Protocol ):Anthropic 于2024 年推出的开放协议,2025 年底捐给Linux 基金会,用于AI 代理与外部工具/数据的标准连接。
RAG:检索增强生成——回答前先从知识库检索相关文档,减少幻觉。
Agent Skill:以 Markdown 等格式封装的、专家编写的结构化工程流程, AI 可按流程执行任务。
BYOK: Bring Your Own Key ,用户自带模型 API Key 接入。
气隙部署( Air-gapped ):完全物理隔离内网运行,数据不出企业。
本文基于公开资料整理(厂商官网、新闻稿、行业媒体),效率数据均为厂商或客户案例口径,实际收益因工程复杂度而异。工具版本迭代很快( AMD 按月更新),使用前请核对官方最新文档。
本页摘要由 AI 辅助整理,经编辑审核后发布;AI 仅用于提炼与分类,原文均附来源链接。