在 100 美元 FPGA 上设计 TPU 并优化 Transformer 推理
在100美元FPGA上设计自己的TPU用于Transformer推理并让它飞速运行
这是我在暑假做的一个项目,目的是学习ML性能优化和软硬件协同设计的基础知识。这个项目的总体目标是在我的Cmod A7 FPGA开发板上运行一个小型Transformer。然后,我希望推导出一些你在LLM缩放规律中常见的结论(目前仅限于单设备),并优化我的内核,看看能从硬件设计中榨出多少性能。我假设你对Transformer推理的工作原理(prefill、decode)有基本了解,但不了解硬件方面。所有代码都可以在项目的GitHub仓库中找到。
我所做的大部分分析(包括下一节),以及TPU架构本身,都深受《Scaling Book》的启发。如果你觉得这篇文章有趣,你可能会喜欢读一读Scaling Book!
是什么决定了我们模型的速度?
在进入硬件之前,我们需要问一个看似显而易见的问题:是什么让模型/算法更快?在ML中,这个问题可以从两个维度来分析:计算和通信。计算是指我们在一定时间内能完成多少原始运算。例如,FLOP/s(每秒浮点运算次数)是衡量GPU或其他ML加速器计算能力的常用指标。因此,一个算法的总计算时间可以用 \(T_{\text{compute}} = \frac{\text{Total FLOPs}}{\text{Accelerator FLOPs/s}}\) 来计算。
另一方面,我们还有通信。在单设备推理中,这通常指内存(HBM、DDR)与加速器缓存之间的通信。在分布式推理中,还必须考虑设备之间的通信。同样,如果我们知道HBM或DDR的内存带宽,就可以计算通信时间:\(T_{\text{comms}} = \frac{\text{通信字节数}}{\text{内存字节/秒}}\)
在大多数硬件中,我们假设通信和计算同时运行,因此理想情况下它们完全重叠。于是,算法运行时间的下界为\(\max(T_{\text{comms}}, T_{\text{compute}})\)。一般来说,我们设计硬件和内核的目标是分析两者之间的瓶颈并加以优化。例如,试图通过使用更多算术单元来加速一个受内存限制的算法是毫无意义的!
矩阵乘法在计算和通信方面具有特殊性质,这使其成为机器学习的支柱。首先,让我们考虑一个\(N\times N\times N\)的矩阵乘法,使用int8(我们的设计使用int4,但int8使字节数更整洁):\(A[N, N] \cdot B[N, N] = C[N, N]\)。在最佳情况下,我们需要加载\(2N^2\)字节到计算单元,然后写回\(N^2\)字节到内存,总共为\(3N^2\)。在计算方面,我们需要执行\(N^3\)次int8乘法。因此,该算法的总算术强度大约为N量级,这意味着矩阵乘法规模越大,计算需求越高。这也是矩阵乘法对机器学习工作负载如此关键的部分原因:只需投入更多计算来实现更大的矩阵乘法,就能非常容易地扩展我们的模型。
模型架构/目标
总体目标是在我们的设计上运行Transformer模型,同时不将其完全固定于单一架构。我们希望能够编写代码来更改模型架构/维度、调整矩阵乘法以提高效率,或运行单元测试来对单层或矩阵乘法进行基准测试。这意味着在硬件中设置固定的控制流是不可接受的。
我们将训练模型并运行推理,任务是预测加法序列中的下一个token,每个输入最多31位数字(整体为64 token预填充和64 token解码),这是一个相当简单但并非平凡的任务。
在基准测试中,我们使用标准Transformer架构,嵌入维度\(d=128\),前馈网络维度\(d_{ff}=512\),4个QKV头,4层。然而,为了便于实现,我们大幅简化了一些操作。首先,我们将gelu激活函数替换为relu。注意力机制中的Softmax也被替换为ReLU,这使得训练更难收敛,但对我们的任务来说没有问题。LayerNorm被替换为hardtanh归一化。最后,我们在训练时前馈网络不使用偏置。虽然这些是相当重大的简化,但整体架构保持不变,分析Transformer推理性能的原始目标仍然可以实现。
在Transformer中,我们有两类操作:矩阵乘法(matmuls),以及逐元素操作如张量加法和ReLU。加速器的目的是从内存中加载张量,执行这些操作,并将结果写回。为了最大化利用FPGA资源和内存,我们选择将激活值和权重量化为int4。
我们的TPU存储层次结构很简单。我们使用Cmod A7开发板,其中包含一颗Artix-7 FPGA芯片以及一颗外部异步SRAM芯片(8位读取,10纳秒访问时间)。我们用SRAM芯片来模拟加速器的外部存储器(真实加速器中的HBM/DDR),用Artix-7的BRAM作为片上缓存(暂存存储器)。
共有3个主要单元:MXU、VPU和DMA。MXU(矩阵乘法单元)负责矩阵乘法,VPU(向量处理单元)负责激活、加法等向量运算。两个单元都从暂存存储器(scratchpad)读取数据,并将结果写回暂存存储器。DMA(直接内存访问)负责暂存存储器与外部存储器之间的数据传输。每个单元由一个软核PicoRV32处理器控制,我们可以为其编写C固件,通过基于AXI的MMIO向各单元分发指令。
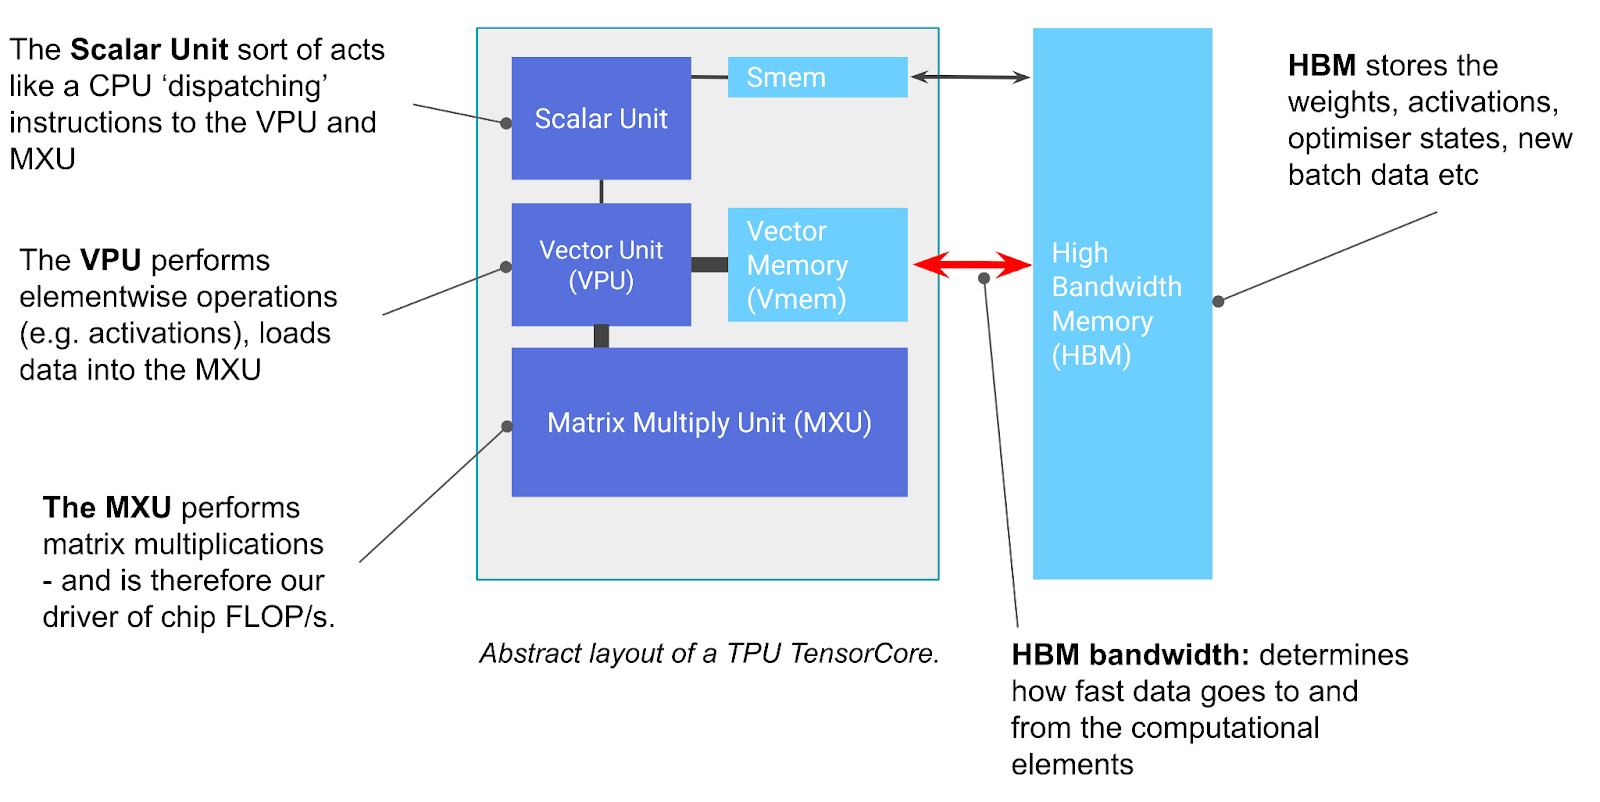
真实TPU TensorCore的抽象布局,我们的设计遵循其形状。来源:How To Scale Your Model
我们的设计有几处不同。Vmem是我们的暂存存储器,HBM是我们的外部SRAM芯片。标量单元就是PicoRV32核心。我们还有一个DMA单元,它实际上负责在SRAM和暂存存储器之间搬移数据。
我们的暂存存储器被综合为简单的双端口BRAM,具有2个独立端口:读和写。由于在我们的使用场景下它可以被综合为几乎任意总线宽度(1 x 32K位到72 x 512位),我们不需要将存储块设计为传统的按地址 % bus_width 索引的bank。相反,我们可以用单个块来表示暂存存储器的一段连续区域。这基本上允许我们拥有任意多个访问暂存存储器的端口,限制条件是2个端口不能访问同一区域;这在后续设计中会非常有用。
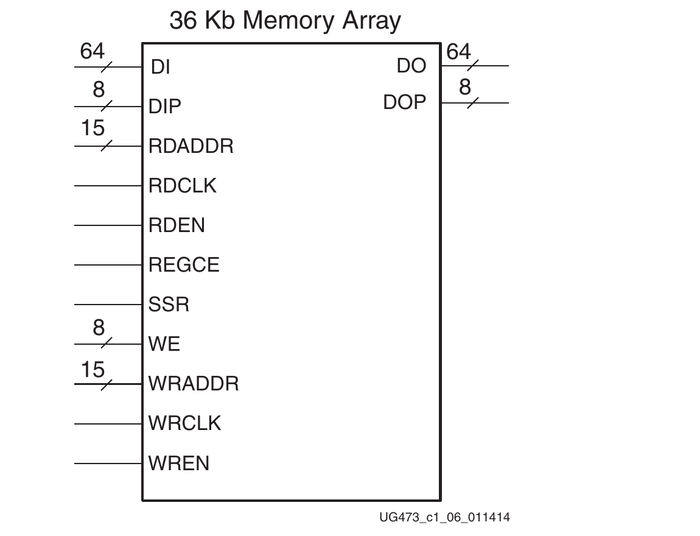
7系列Block RAM在简单双端口模式下的结构:在同一个36 Kb阵列上提供一个读端口和一个写端口。来源:Xilinx UG473,《7 Series FPGAs Memory Resources》
我们的DMA非常简单。在Cmod A7标准的12 MHz时钟下,10 ns的外部RAM访问时间基本可视为瞬时;数据在下一个时钟沿即可到达。DMA单元接收暂存器和外部RAM的基地址、行步长以及二维矩阵维度,然后直接驱动外部RAM和暂存器的端口以在两者之间传输数据。然而,有一个细节需要注意:由于我们的外部SRAM是异步的且访问时间为10 ns,WE(写使能)信号需要在地址和数据信号到达并稳定之后才能有效。这意味着每写入一个字节,我们需要在时钟的下降沿将WE拉高再拉低。因此,我们最终的带宽为:外部→暂存器方向每时钟1字节,暂存器→外部方向每时钟0.5字节。
对于矩阵乘法,我们使用输出驻留的8x8脉动阵列;每个PE保留其部分和,同时将其输入值传递给右侧和下方的下一个PE。这允许我们执行任意8xNx8(\(A[8,N] \cdot B[N,8]\))的矩阵乘法,只要A和B能放入scratchpad。默认情况下,所有张量在外部存储器和scratchpad中均以行主序存储。由于我们的设计没有快速转置矩阵的方法,我们改为在MXU中使用一种技巧来执行转置矩阵乘法,例如注意力中的\(QK^T\)。默认情况下,A和B按如下方式馈入脉动阵列:
MXU的2x2版本;实际版本为8x8。每个PE存储一个输出元素\(c_{ij}\)。左侧,不转置:A的第\(i\)行(蓝色)作为一个连续块加载到该行的寄存器中,每个时钟移出一个元素。整个B行一次性到达,寄存器对输入数据进行偏移。右侧,转置:B改为以\([N, K]\)存储,因此一列的元素是连续的,B以与A相同的方式馈入。这使得转置矩阵永远不需要在内存中重新排列;MXU只是以不同方式读取它们。
因此,每个时钟周期,脉动阵列会为矩阵 A 读取 \(32\) 位(8 个 int4 值),为矩阵 B 读取 \(32\) 位。这正是暂存器架构的用武之地:只要 A 和 B 位于不同的内存区域,它们就可以同时被读取,而不会干扰正在进行的 DMA 操作。由于全部 \(64\) 个 PE 每个时钟周期各累加一个乘积,我们的 MXU 每时钟周期完成 \(64\) 次乘加运算,这就是本文后续将采用的计算数值。
VPU 相当简单。它的输入是一个向量的基地址和操作长度。它会反复从暂存器中加载向量的数据块,对其进行操作(加法、relu 等),然后写回,直到操作完成。
设计选择及其他说明
我们使用 PicoRV32,以便轻松地为不同架构编写固件。这不仅使得我们可以在推理和不同架构之外进行单元测试,还使我们能够在后续轻松实验各种优化,而无需更改硬件中的数据流。
在设计架构时,CPU 指令发射开销也是一个考虑因素。当 CPU 分发指令时,指令会进入每个单元的命令队列,随后与 CPU 执行顺序异步执行。为实现同步,CPU 还可以轮询每个指令队列的状态。此外,为最小化执行延迟的影响,TPU 操作被有意设计得较为复杂,使指令能够跨越较大的地址范围而无需更多 CPU 分发调用。
固件与内核
现在我们需要对 PicoRV32 核心进行编程以执行推理。首先,我们定义编程方案:
我们首先实现向 TPU 的基本指令分发。之后,我们实现原语,即 matmul 和逐元素函数。
优化 Matmul
我们很幸运,相对于外部 SRAM(512 KB),我们拥有一个相对较大的暂存器(64 KB),比例为 1:8。在预填充阶段 d=128、d_ff=512、T=64 时,我们最大的 matmul(位于 FFN 中)需要约 \((128 * 512 + 64 * 128 + 64 * 512) / 2 = 53,248\) 字节(52 KB),完全可以放入我们的暂存器中!这意味着对于我们基准测试中的 matmul,我们基本上总能达到理论上的 \(NM + MK + NK\) 字节加载量,因为在进行分块时我们不需要两次加载矩阵的同一块。
我们将 matmul 实现为输出矩阵上基于 \(8\times 8\) 分块的 tiled matmul。以下是该内核的伪代码:
输入(位于外部存储器):A[M, K]、B[K, N] 输出(位于外部存储器):C[M, N] 在 scratchpad 中分配 A_tile[8*S, K]、B_tile[K, 8]、C_tile[8, 8],置于不同区域。(选择 S 使其在不溢出 scratchpad 的前提下最大化。)for i from 0 to M, with step 8*S: 将 A[i:i+8*S][:] 从外部存储器拷贝至 A_tile for j from 0 to N, with step 8: 将 B[:][j:j+8] 从外部存储器拷贝至 B_tile 等待所有 DMA 完成 for k from 0 to 8*S, with step 8: tpu_matmul A_tile * B_tile -> C_tile 等待 mxu 完成 将 C_tile 从 scratchpad 拷贝至 C[i:i+8][j:j+8] 而如果我们改为想要 \(C = AB^T\),则改为将 B[j:j+8][:] 加载至 B_tile,并在调用 mxu 时分派一个 transpose 标志。
该算法使用的 scratchpad 内存少于我们刚刚计算的上界,并且通过自动适配 S 变量,它还支持无法完全放入 scratchpad 的 matmul。然而,在这种情况下,我们会失去上述性质,因为 B 的每个元素都必须被多次加载。
但这仍然不是最优的!请记住,最优情况下,我们的运行时间是 MXU 时间与 DMA 时间的最大值。我们需要一种方法让 DMA 访问与 MXU 重叠。为此,我们改为在 scratchpad 中为 B_tile 分配 2 个区域,从而允许我们对 DMA 加载进行双缓冲。这样,当我们的 MXU 在 k 循环中处于活动状态时,我们同时将下一块 B 加载到非活动的 B 缓冲区。我们将在后面详细讨论我们所做的每项优化的结果。
优化完整推理
除了矩阵乘法,我们还实现了逐元素操作。这非常简单;只需将张量复制到暂存区,在对应地址上调度VPU,然后写回外部存储器。如果张量无法完全容纳,就将其分块加载到暂存区并多次执行。
现在我们准备好实现完整的推理内核了!使用我们的模型架构,单层的完整预填充过程如下所示:
模型参数:嵌入维度d,头数(heads),头维度d_h = d/heads。输入(位于外部存储器中,每层重复):查询token数S,键/值token数T,注意力权重W_Q/K/V/O[d, d],FFN权重W_1[d, 4d]、W_2[4d, d],token嵌入X[T, d]。输出(位于外部存储器中,每层重复):KV缓存[T, 2d]。对每一层:Q[S, d] = tpu_matmul(X, W_Q);K[T, d] = tpu_matmul(X, W_K) // 直接写入对应的KV缓存地址;V[T, d] = tpu_matmul(X, W_V) //;O[S, d] = 空向量;对h从0到heads-1:P[S, T] = tpu_matmul.transposed(Q[:][h * d_h +: d_h], K[:][h * d_h +: d_h]);P = P + mask;P = relu(P);O[:][h * d_h +: d_h] = P @ V[:][h * d_h +: d_h];O = tpu_matmul(O, W_O);O = O + X;O = hardtanh(O);A[S, 4d] = tpu_matmul(O, W_1);A = relu(A);Y[S, d] = tpu_matmul(A, W_2);Y = Y + O;X = hardtanh(Y)。在预填充中,S=T。
解码只是这种情况的一个特例,其中S=1,且K/V矩阵从KV缓存加载,而非每一步重新计算。让我们运行一次完整的推理,包括预填充和解码:
base:运行 57695827 个时钟周期,4807.986 ms @ 12 MHz;MXU 忙碌 9752832(16.9%),VPU 忙碌 483616(0.8%),DMA 忙碌 32695968(56.7%),无单元忙碌(发射开销)14763411(25.6%),生产者因队列满而停顿 0(0.0%),两个或以上单元同时忙碌 0(0.0%)。双缓冲:运行 47183187 个时钟周期,3931.932 ms @ 12 MHz;MXU 忙碌 9752832(20.7%),VPU 忙碌 483616(1.0%),DMA 忙碌 32695968(69.3%),无单元忙碌(发射开销)12714599(26.9%),生产者因队列满而停顿 0(0.0%),两个或以上单元同时忙碌 8463828(17.9%)。而仅使用 prefill 时:
base:运行 3719516 个时钟周期,309.960 ms @ 12 MHz;MXU 忙碌 1097010(29.5%),VPU 忙碌 242200(6.5%),DMA 忙碌 2016984(54.2%),无单元忙碌(发射开销)363322(9.8%),生产者因队列满而停顿 0(0.0%),两个或以上单元同时忙碌 0(0.0%)。双缓冲:运行 3372036 个时钟周期,281.003 ms @ 12 MHz;MXU 忙碌 1097010(32.5%),VPU 忙碌 242200(7.2%),DMA 忙碌 2016984(59.8%),无单元忙碌(发射开销)383315(11.4%),生产者因队列满而停顿 0(0.0%),两个或以上单元同时忙碌 367473(10.9%)。我们可以看到,双缓冲带来了很大帮助!它在完整推理中将运行时间改善了约 18%,在 prefill 中改善了 9%。显然,我们尚未实现计算与通信的完全重叠,但在不于硬件中设计乱序执行的情况下,这大概已经是我能达到的最好结果了。
本页摘要由 AI 辅助整理,经编辑审核后发布;AI 仅用于提炼与分类,原文均附来源链接。