Xilinx MIG与开源DDR3控制器对比
将Xilinx MIG与开源DDR3控制器进行对比
去年,我有幸指导Angelo构建了一个开源DDR3 SDRAM控制器。
今天,我有机会将该控制器与AMD(Xilinx)针对同一问题的内存接口生成器(MIG)解决方案进行对比。让我们来看看哪一个更快、更好和/或更便宜。
设计差异
在深入对比之前,有必要了解一些关于DDR3的知识——包括其工作原理以及这如何影响其性能。在此基础上,我想简要讨论Xilinx MIG与UberDDR3控制器之间的一些主要设计差异。
我们将从SDRAM控制器的通用需求开始。
SDRAM概述
SDRAM代表同步动态随机存取存储器。“同步”在此语境下仅表示该接口需要一个时钟,且所有交互都与该时钟同步。“随机存取”意味着你可以按任意顺序访问存储器。然而,这个缩写中的关键词是代表动态的“D”。
“动态”RAM由电容而非触发器构成。原因在于:电容可以做得比触发器小得多,而且能耗也远低于触发器。当电容充电时,其所代表的存储“位”为“1”;未充电时,该位为“0”。但存在一个关键问题:电容会随时间流失电荷。这意味着内存中的每个电容都必须被定期读取并重新充电,否则将丢失其内容。内存控制器负责通过向内存发出“刷新”命令来确保这一过程得以执行。
这只是第一个挑战。现在我们回到“同步”这一部分。
最初的(非DDR)SDRAM标准只有单一时钟。控制器会生成该时钟并发送至内存,以控制所有交互操作。
这很快就显得不够快了。为什么不把存储器数值在时钟的上升沿和下降沿都发送,而不是只在一个边沿发送呢?这样在相同I/O带宽下,接口上传输的数据量就能翻倍。遗憾的是,随着速度提高,存储器返回的数据很快就无法与发送的时钟保持同步。电路板上的走线以及存储器芯片内部完成操作所需的时间,都会使返回信号延迟到这样的程度:返回数据来不及在下一个时钟边沿之前由源端时钟在源端采样。更糟的是,这些变化在某种程度上是不可预测的。因此,存储器经过了修改,使其在返回数据的同时返回一个时钟——从而让数据与其随行的时钟保持同步。
对FPGA而言,用返回时钟来采样数据可能是一项挑战。更糟的是,返回时钟是不连续的:只有当存储器有数据要返回时它才有效。这会在后面给我们带来麻烦,所以我们稍后再回头讨论。
现在,让我们回到SDRAM中“动态”的那一部分。
SDRAM按bank组织,每个存储bank由多行电容构成。要从SDRAM读取数据,必须首先“激活”特定存储bank中的一行数据,即需要将该行数据从电容行复制到触发器行中。随后,可按需读写该行内的“列”。然而,每个bank在同一时间只能有一行处于活动状态。因此,若要访问第二行存储数据,必须先将当前使用中的行复制回其电容,这一过程称为对该行进行“预充电”。只有完成预充电后,才能将目标行或存储数据复制到活动触发器行以供访问。
我提到过,SDRAM按“bank”组织,每个“bank”均可独立控制,各自拥有独立的活动触发器行。除少数例外情况(如“预充电所有行”命令或“刷新”周期命令)外,发送至存储器的大多数命令都是针对特定bank的。
因此,要读取一个字节的内存,控制器必须首先确定该字节属于哪个bank,然后确定要读取哪一行。接着控制器必须检查该bank的触发器缓冲区中当前是哪一行处于活动状态。如果活动的是另一行,则必须先对该行进行预充电。如果没有活动行,或者原先的活动行已完成预充电,控制器便可激活目标行。只有当目标行处于活动状态后,控制器才能发出命令真正从该行读取目标字节。哦,还有……所有这些的前提是不需要刷新内存。如果发生刷新中断,你必须对所有bank进行预充电,刷新内存,然后从头开始。
嗯,差不多是这样。还有一个重要细节:由于我们所讨论的是高速传输,内存会以8字节突发的方式返回数据。因此,你不能只读取单个字节。最小读取量是单个“字节通道”中的8个字节。
如果每次八字节的吞吐量对你来说不够用怎么办?你可以将多个内存芯片并行连接在一起。在这种情况下,控制器发出的每条命令都会发送到所有内存芯片。它们会一起激活行、一起刷新存储器,并且每个芯片都能一次读取八字节。于是,每个芯片控制一个“字节通道”。在今天我们的案例中,我们将使用一个具有八个“字节通道”的存储器。
那么,在内存控制器的性能方面,我们想知道什么?我们想知道从控制器接收到读(或写)请求开始,到数据能够从内存芯片返回为止需要多长时间。这包括等待任何(可能的)刷新周期、等待先前激活的行被预充电、新行被激活,以及数据最终返回。数据路径足够复杂,我们需要从统计角度来考察这些时间。
具体来说,我们将把事务时间建模为一定量的每事务延迟,随后是一定量的每单位吞吐量。
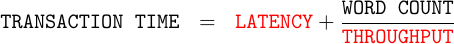
我们的目标是确定这两个未知量:延迟和吞吐量。如果我们做得好,这两个数字将帮助我们预测诸如以下问题的答案:某个特定算法需要多长时间,以及应用程序可用的内存带宽有多少。
现在我们讨论一下 AMD(Xilinx)的 DDR3 内存控制器。这是由其“Memory Interface Generator”生成的控制器,通常被亲切地简称为“MIG”或“MIG 控制器”。
AMD(Xilinx)的 MIG 控制器如今已推出多年。从其变更日志判断,它最早于 2013 年发布。除配置调整外,自 2016 年以来未做过重大修改。这被视为其较为“稳定”的 IP 之一。它被各类用户广泛使用,我本人也在大量项目中使用过它。
查看 MIG 的源代码可以发现,它由两部分构成。这可以从下面的图 1 中看出,该图展示了 MIG 在我们今天将使用的整个测试栈中的位置关系。
MIG 的第一部分将 AXI 事务请求处理为其内部“原生”接口。然而,AXI 是一种复杂的协议。这一转换并非瞬时完成,因此需要一(或两)个时钟周期来完成。许多 FPGA 设计者发现,他们通常可以通过跳过这一 AXI 转换层并改用“原生”接口来提升 MIG 的性能。我本人尚未这样做,因为我还没有找到足够满足我需求的关于这一“原生”接口的文档——但也许我只是需要更仔细地研究一下现有的资料。
AXI接口的一个关键特性是允许一定程度的事务重排序。例如,内存控制器可能优先处理对同一内存bank的两次交互,使得使用当前活动行的交互先执行。Xilinx的MIG是否这样做,我无法确定。在今天的测试测量中,我们只使用一个通道——无论是读还是写,并且只使用单个AXI ID。因此,所有请求必须按顺序完成,MIG没有机会对任何请求进行重排序。
DDR3的速度也往往远快于控制器必须支持的FPGA逻辑速度。因此,Xilinx的DDR3控制器以接口速度的1/2或1/4运行。这意味着,在任意给定的FPGA时钟周期内,可以向DDR3器件发出两条或四条命令。在本次测试中,我们将以1/4速度运行,因此每个系统时钟周期可以发出四条命令。
Xilinx需要用其控制器解决的最大问题是如何采样返回数据。请记住,存储器返回的数据包含一个不连续时钟。更糟糕的是,不连续时钟在数据跳变时也会跳变。这意味着控制器必须(通常)将返回时钟延迟四分之一周期,然后才能在该边沿上对数据采样。但是……你如何知道四分之一周期的延迟是多少,以便为每个字节通道生成正确的采样时间?
Xilinx 通过使用一组从未完整文档化的 IO 原语解决了这个问题,其中包括 PHASOR 和 IO FIFO。利用这些 IO 原语,他们可以将 PLL 锁定到返回的数据时钟,然后使用该 PLL 控制返回数据的采样时刻。该时钟随后用于控制一个专用异步 FIFO。至此,数据被返回至其所在环境。
我从 MIG 中观察到的一个不寻常细节是,它经常以周期性方式将我的读请求停顿单个周期。这种停顿对于任何刷新周期而言都太短了。它们的出现频率也高于(时间更长的)刷新周期。这使我确信 Xilinx 的 IO PLL 原语有一个额外要求,即为了保持锁定,MIG 必须周期性地从 DDR3 SDRAM 读取。因此,MIG 不仅必须周期性地将存储器离线以保持电容刷新,还必须从存储器读取以保持该 IO PLL 锁定。更糟的是,它在执行这种“站位保持”时无法同时从器件读取。与 AXI 到原生转换的情况一样,这种 PLL 站位保持要求对 MIG 的性能产生了负面影响。
在结束这一点之前,我要强调这些“专用”IO单元从未被完整记录。这增加了构建开源控制器的难度,因为开源工程师要么必须逆向工程这些未记录的硬件组件,要么以其他方式构建其数据采样器。
前一段时间,我尝试构建一个基于块RAM的存储器外设,能够处理AXI独占访问请求。在尝试验证ZipCPU能够生成独占访问请求并且能够正确生成时,我研究了MIG是否支持这些请求。令我非常惊讶的是,MIG不具备独占访问能力。后来有人告诉我这没什么大不了的,因为只有在同一总线上运行多个CPU时才需要独占访问,而MicroBlaze CPU从未获得多核操作的认证,但我仍然认为这很重要。
最后,MIG控制器试图通过各种“bank machine”来最大化并行性。这些“bank machine”似乎是复杂的结构,在请求时动态分配。每个bank machine负责处理给定内存bank的行何时以及是否需要激活、读取、写入或预充电。虽然大多数存储器物理上有八个bank,但Xilinx的MIG允许用户使用更少的bank machine。因此,响应用户请求的第一步是为该请求分配一个bank machine。根据Xilinx的说法,“[MIG]控制器实现了激进的预充电策略。”结果,一旦请求完成,如果没有其他待处理的请求,控制器将对bank进行预充电。这一决策的不利后果是,对同一内存的后续访问将需要首先再次激活该行才能使用。
这引出了UberDDR3控制器。
UberDDR3控制器是一个开源(GPLv3)DDR3控制器。它并非在AMD(Xilinx)的资助或帮助下构建。因此,它不使用任何专用IO特性。相反,它使用基本的ISERDES/OSERDES和IDELAY/ODELAY原语。结果是,没有PHASER_IN、PHASER_OUT、IN_FIFO、OUT_FIFO或BUFIO。
这就引出了如何处理来自DDR3器件的返回时钟采样问题。在UberDDR3控制器中,我们假设DQS翻转总是在包含请求的时钟之后固定时间返回。使用一个小型校准状态机来确定该延迟时间,然后找到“眼图”的中心。完成后,使用IDELAY元件配合移位寄存器来获取采样点。
图2展示了这一过程的参考。
这种方法有可能随时间推移而丢失校准。事实上,即便是MIG也希望使用XADC来监测温度变化,以判断是否需要调整其校准。UberDDR3控制器不需要XADC,而是支持用户输入使其重新进入校准模式。实际上,我并不需要这样做,但这也可能是因为我的测试持续时间不够长。
UberDDR3控制器与MIG之间的另一个区别是,UberDDR3控制器只有一个接口:Wishbone B4(流水线式)。该接口足够健壮,可以替代MIG非标准“原生”接口的需求。此外,由于Wishbone对于读写只有一个通道,UberDDR3控制器对所有事务保持严格的顺序。不存在重新排序访问的机会,也不涉及相关的复杂性。
然而,这会使我们的测试稍微困难一些,因为我们将发出Wishbone请求——这是UberDDR3控制器原生的请求,而非MIG。一个简单的桥接器(仅消耗一个时钟周期)将在MIG之前将Wishbone转换为AXI。我们在测试时需要考虑到这一点。
UberDDR3控制器在处理内存bank方面也有所不同。它不采用“激进”的预充电策略,而是采用惰性策略。只有在以下情况下才会对行进行预充电(返回到电容):1)该行活跃时间过长,或2)需要进行刷新时,此时所有bank上的所有活跃行都必须预充电。这一策略在“下一次访问很可能位于上一次访问附近”的假设下运行良好。
UberDDR3控制器处理内存bank的第二个不同之处在于,与MIG不同,bank地址取自行地址和列地址之间的位,如图3所示。
尽管MIG提供了执行此操作的选项,但尚不清楚MIG是否利用了这种安排的任何优势。另一方面,UberDDR3控制器在设计上明确利用了这种安排的优势。具体而言,UberDDR3控制器假设大多数访问将通过内存顺序进行。因此,当它收到一个内存访问请求,且该请求位于给定行的列空间的大部分位置时,它便会激活下一个bank中的下一行。这一操作独立于任何用户请求而发生,因此是对未来可能(也可能不)发生的用户请求的预判。
本页摘要由 AI 辅助整理,经编辑审核后发布;AI 仅用于提炼与分类,原文均附来源链接。